【本网讯】近日,我校吴锡教授团队与电子科技大学合作完成的研究论文“High Performance Batched Symmetric Eigenvalue Decomposition via MRRR Tridiagonal Solver”(基于MRRR 三对角求解器的高性能批量对称矩阵特征值分解)获国际顶级会议PPoPP 2027录用,成都信息工程大学为论文第一完成单位。这是我校首篇获PPoPP录用的论文,也是学校首篇获计算机体系结构领域CCF A类国际会议录用的论文。
PPoPP(ACM SIGPLAN Symposium on Principles and Practice of Parallel Programming,并行编程原理与实践研讨会)是并行编程与高性能计算领域的国际顶级学术会议,被中国计算机学会(CCF)列为“计算机体系结构/并行与分布计算/存储系统”领域的 A 类会议。
论文第一作者为我校计算机学院2025级研究生靳喜,我校新引进的王瀚生博士、我校吴锡教授和电子科技大学张少帅研究员为共同通讯作者。
据会议录用通知,本届会议共收到398篇投稿,仅69篇论文获录用,录用比例约为17.34%。我校研究成果从本届投稿中脱颖而出,体现了团队在GPU并行算法与基础数值计算优化方面的研究水平。
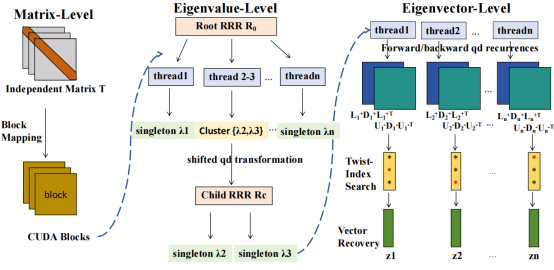
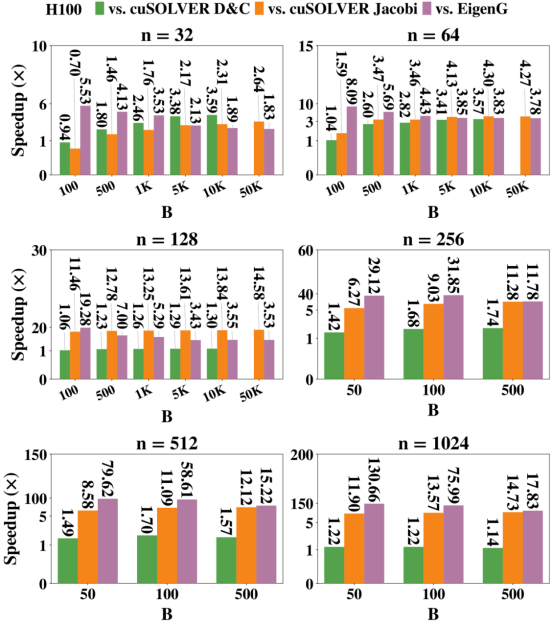
对称矩阵特征值分解是数值线性代数中的基础运算。在二阶优化、医学成像等应用中,常需同时求解大量彼此独立的中小规模对称矩阵特征值问题。现有GPU批量求解方法仍存在不同的性能局限:Jacobi方法需要多轮旋转迭代,计算开销较大;分治(D&C)方法的递归合并增加数据搬运开销;隐式QL方法受迭代依赖制约,并行度有限。针对上述问题,团队提出了一种基于多重相对鲁棒表示(MRRR)的GPU批量对称矩阵特征值分解方法。据团队调研,该工作首次将GPU批量MRRR三对角求解器集成到端到端的批量稠密对称矩阵特征值分解流程中。该方法采用矩阵级、特征值级和特征向量级三级并行设计,充分挖掘不同矩阵及独立特征对之间的并行性,并根据矩阵规模优化求解流程,提高完整对称矩阵特征值分解的批量处理效率。在NVIDIA H100 GPU的测试中,相较cuSOLVER Jacobi、cuSOLVER D&C和EigenG-Batched,该方法在所测试配置中的端到端最高加速比分别达到14.73倍、3.59倍和130.66倍,展示了三级并行设计与流程协同优化在批量数值计算中的性能潜力。